Главное изменение
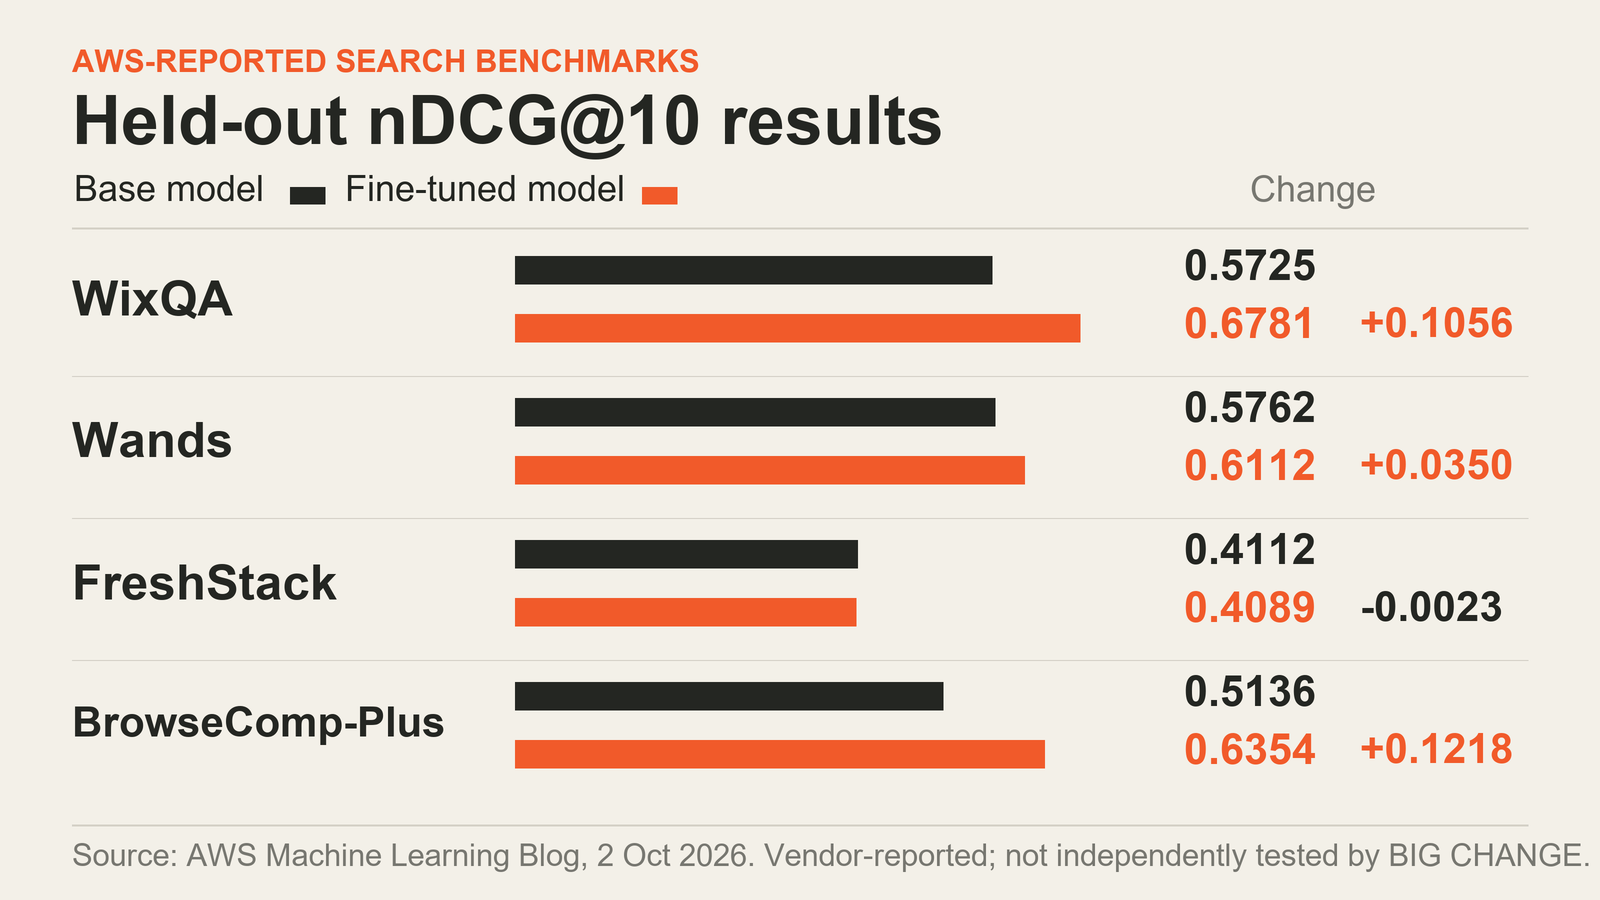
В своём обзоре от 2 октября, AWS описывает дообучение поискового агента Qwen3.6-27B методом многошагового обучения с подкреплением (MTRL) в SageMaker AI. На диаграмме выше показаны опубликованные AWS значения nDCG@10 на отложенных выборках: они выросли для WixQA, Wands и BrowseComp-Plus и немного снизились для FreshStack. BIG CHANGE построила диаграмму по данным AWS; мы не тестировали агента независимо и не воспроизводили результаты. Этот метод обучает модель на итогах последовательности решений с использованием инструментов.
Перед отправкой задания специалисту по машинному обучению нужно убедиться, что модель поддерживается в выбранном регионе, агент может работать в цикле выполнения SageMaker, запросы и вознаграждения соответствуют поисковой задаче, а отдельная оценочная выборка выявляет ухудшения. Руководство основано на документации AWS; BIG CHANGE не запускала задания AWS и не вызывала API.
Как MTRL меняет цикл обучения
При обучении с учителем команде нужны примеры траекторий, показывающие желаемое поведение. Согласно описанию AWS, при MTRL SageMaker передаёт агенту запросы, агент в несколько ходов обращается к модели политики и инструментам, а после завершения цикла сообщает вознаграждение. По этой обратной связи обновляется модель. В поисковой задаче вознаграждение может оценивать итоговое ранжирование, поэтому первые запросы оптимизируются с учётом всей поисковой сессии.
Это различие важно, когда вызовы инструментов зависят от предыдущих результатов. Если модель начинает с неудачного запроса, получает слабые результаты и должна переформулировать запрос, вознаграждение в конце задачи может учитывать, удалось ли последовательности действий найти релевантные документы. Однако сначала нужно определить, что значит «релевантный», и создать агента, способного вызывать поисковые инструменты команды.
Сначала проверьте доступ, модель и регион
В примере от 2 октября использовался регион Запад США (Орегон), us-west-2, модель Qwen3.6-27B для дообучения. В таблице поддерживаемых моделей SageMaker MTRL, проверенной 4 октября 2026 года, указаны четыре модели в шести сочетаниях моделей и регионов: Nova Lite 2.0 и GPT-OSS-20B — в Востоке США (Северная Вирджиния), us-east-1и Западе США (Орегон), us-west-2; Gemma-4-31B-it и Qwen 3.6 27B — только в Орегоне. Проверьте актуальную таблицу для региона, где собираетесь создать задание: наличие модели в списке не означает, что она доступна в других регионах.
Команде также нужна учётная запись AWS и, при работе через интерфейс Studio, домен SageMaker Studio; доступ к S3 для наборов данных и результатов; а также роли IAM, настроенные для новых заданий MTRL и вызовов среды выполнения. Согласно предварительным требованиям AWS, вызывающей стороне нужны CreateJob и связанные действия с заданиями, а также право передать роль выполнения сервису job.sagemaker.amazonaws.com. Для роли выполнения необходима политика AmazonSageMakerJobFullAccess и этот субъект-служба в доверительной политике. Роли среды выполнения агента нужна политика AmazonSageMakerJobRuntimeAccess; для среды выполнения AgentCore также требуется отдельное доверительное отношение. Средству выбора среды выполнения в Studio нужны разрешения на просмотр AgentCore. По данным AWS, широкий существующий доступ SageMaker сам по себе не включает все новые действия с заданиями.
В документации описаны два способа подключить агента. Разверните его в Bedrock AgentCore для управляемого размещения — AWS указывает, что этот вариант лучше всего работает с агентами на Strands, — или разместите собственный агент и подключите его через Lambda-перенаправитель. Агент получает запросы для цикла, вызывает модель политики через среду выполнения заданий SageMaker, запускает поисковые инструменты, завершает цикл и сообщает вознаграждение. Декоратор SDK от AWS упрощает интеграцию; собственные фреймворки могут вызывать API среды выполнения напрямую. Если функция Lambda имеет нестандартное имя, AWS указывает, что её ARN, возможно, придётся явно добавить в политику разрешений. Собственная VPC или ключ KMS требуют дополнительной настройки.
Подготовьте запросы и вознаграждение для реальной поисковой задачи
В руководстве SageMaker по ресурсам принимаются форматы Parquet, JSON Lines, JSON и CSV. Сервис ищет столбец с именем prompt, а если его нет — использует первый столбец и передаёт значение агенту без изменений. Сервис не анализирует, не проверяет и не преобразует содержимое запроса. Для поиска с инструментами запрос может содержать историю сообщений, метаданные задачи, описание вознаграждения и конфигурацию инструментов в ожидаемом агентом формате. AWS предупреждает, что запросы передаются без проверки, поэтому команда сама отвечает за защиту конфиденциальных данных: шифрование или другую подходящую защиту следует предусмотреть для хранилища и пути выполнения агента.
Вознаграждение — это цель, которую оптимизирует модель. В примере AWS используется nDCG@10 для итоговых найденных документов; если агент достигает лимита ходов или генерируемых токенов, ему назначается вознаграждение -1. Это конкретная отправная точка для ранжирования результатов, но от выбора оценки многое зависит: нужны надёжные метки релевантности или другой обоснованный способ подсчёта. Следует также проверить, не поощряет ли вознаграждение формальный рост ранжирования в ущерб качеству ответов, задержке или расходам на инструменты.
В публикации сказано, что в обучающую смесь вошли FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique и MLQA; пять процентов обучающих примеров каждого набора использовались для проверки. Отложенная тестовая выборка включала FreshStack, WixQA, BrowseComp-Plus и Wands. Эти общедоступные или синтетические наборы не заменяют оценку на частном корпусе и распределении запросов, для которых команда собирается запустить сервис.
Отправьте небольшое задание, результаты которого легко проверить
В блоге AWS от 2 октября в примере кода используются другие импорт SDK и имена аргументов. В актуальном справочнике по обучающим заданиям SageMaker показан следующий формат API для среды выполнения Bedrock AgentCore. В примере указан текущий документированный AWS идентификатор модели GPT-OSS-20B; выберите модель, доступную в целевом регионе, и перед адаптацией проверьте действующую таблицу поддерживаемых моделей. Для текущего примера также нужны ARN приложения MLflow, ARN роли и принятие лицензионного соглашения EULA.
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
Это пример из актуальной документации AWS, а не команда, проверенная BIG CHANGE. В блоге AWS от 2 октября приведены другие sagemaker.modules.train импорт, model_id, agent_endpoint, training_dataset_s3_uri и аргументы output_s3_uri. Поскольку они расходятся с актуальным руководством по заданиям, при новой реализации следуйте текущему справочнику и проверьте версии SDK и требования к модели в своей среде. Мы не выяснили, объясняется ли расхождение более старой версией SDK в примере блога или несогласованностью документации. Ещё один документированный способ отправки — интерфейс Studio: выберите поддерживаемую модель JumpStart, укажите Multi-Turn Reinforcement Learning, настройте среду AgentCore или Lambda-перенаправитель, предоставьте обучающие данные и отправьте задание.
Для первого запуска зафиксируйте модель, регион, версию набора данных, вознаграждение, ограничения, гиперпараметры и путь сохранения результатов, чтобы сравнивать последующие оценки с тем же исходным уровнем. При использовании собственной VPC отдельное руководство AWS предусматривает частные подсети в двух зонах доступности, конечные точки VPC для S3 и CloudWatch Logs, а также, где применимо, конечную точку AgentCore или Lambda; для MLflow тоже нужна конечная точка. Роли выполнения требуются разрешения на управление ENI. Необязательная настройка с собственным ключом KMS требует дополнительных разрешений и настройки политики ключа для вызывающей стороны, роли выполнения и среды выполнения; по умолчанию данные в покое шифруются ключом AWS. Перед выбором этих конфигураций изучите руководства по VPC и шифрованию. До отправки проверьте квоты аккаунта: по умолчанию AWS допускает одновременно одно задание дообучения MTRL и одно оценочное задание; обе квоты можно изменить через Service Quotas. Ограничения частоты API управления заданиями изменить нельзя.
Оцените модель на отложенных запросах до развёртывания
В документации AWS по оценке рекомендуется исключить оценочные запросы из обучения, использовать одинаковый формат запросов, охватить важные инструменты и их сочетания, добавить ранее неудачные случаи и защитить конфиденциальные данные. Оценщик SageMaker может запустить кандидатную модель на наборе запросов и сообщить вознаграждение, pass@k и метрики траекторий. Документация также показывает сравнение дообученной и, по желанию, базовой модели в одном конвейере.
Определите протокол оценки до обучения. Зафиксируйте отдельную выборку, отражающую запросы, разрешения и изменения документов, с которыми столкнётся работающий агент. Сравнивайте базовую и дообученную модели на тех же инструментах, с теми же ограничениями и кодом подсчёта. Анализируйте не только среднюю оценку поиска, но и сбои задач, число ходов, задержку, расход токенов и случаи, когда релевантные документы выпадают из верхних позиций. Документация объясняет, как отправить оценочное задание AWS, но не доказывает, что какая-либо одна метрика полностью отражает качество производственного поиска.
В публикации AWS указаны следующие результаты на отложенной выборке:
Набор данных (вопросы) | Базовая nDCG@10 | nDCG@10 после дообучения | Частота сбоев базовой модели | Частота сбоев дообученной модели |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
В таблице nDCG@10 выросла для трёх наборов и немного снизилась для FreshStack. AWS связывает снижение частоты сбоев на BrowseComp-Plus со штрафом за достижение лимита ходов или токенов. В блоге нет доверительных интервалов и анализа статистической значимости этих показателей. Также сообщается, что дообученная модель в среднем совершала 4,5 хода против 4,3 у базовой на WixQA и 2,9 против 2,2 на Wands: число ходов уменьшилось не везде. Это эксперимент, о котором сообщил поставщик, а не независимая проверка и не доказательство улучшения на других корпусах.
Заложите в бюджет все расходы пробного запуска
В документации AWS по MTRL описаны три составляющие расходов на обучение: входные токены prefill, обработанные как данные, токены, сгенерированные при выполнении циклов, и обновления модели. На странице цен приведены ставки для каждой модели. На смету также влияют число циклов, длина последовательностей, эпохи и время работы. В статье-примере общая сумма счёта не указана, и документация не приводит единую цену пробного запуска для всех случаев. Проверьте актуальную ставку выбранной модели и региона и оцените расходы по ожидаемому использованию задания, а не по фиксированной цене.
Учтите и сопутствующие расходы: хранение и запросы S3 для обучающих и проверочных данных, контрольных точек и результатов; среду AgentCore или Lambda и вспомогательную поисковую инфраструктуру во время циклов; журналы и MLflow; оценку на отложенных данных; конечную точку или развёртывание в Bedrock после обучения. AWS отдельно рекомендует останавливать или удалять выполняющееся задание MTRL, удалять ненужные артефакты моделей в S3 и убирать оценочные конечные точки, чтобы избежать дальнейших списаний. Развёртывание конечной точки — отдельное решение и статья расходов, не входящая в обучение.
Решите, стоит ли продолжать
Этот процесс наиболее уместен для поисковой задачи, где нужны несколько зависимых вызовов инструментов и команда может оценить итог. Пробный запуск поможет принять решение, только если выбрана поддерживаемая пара «модель — регион», интеграция агента работает, запросы представляют реальные данные, вознаграждение отражает задачу, есть сравнение на отложенной выборке и смета учитывает сопутствующие сервисы. Хорошие результаты на четырёх тестах AWS — повод изучить метод, но не основание ожидать такого же эффекта на другом индексе, составе запросов или наборе разрешений.
Источники и дополнительная литература
- AWS Machine Learning Blog: «Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI» (2 октября 2026 года) — руководство поставщика, настройка, выбор данных и опубликованные результаты оценки.
- Amazon SageMaker AI: Multi-turn reinforcement learning — актуальные поддерживаемые модели, регионы и составляющие тарификации.
- Предварительные требования, Подготовка агента, Настройка VPC и шифрование данных в покое — разрешения, варианты среды выполнения, интеграция и дополнительная настройка сети и шифрования.
- Создание ресурсов, отправка обучающего задания, оценка, гиперпараметры и квоты — актуальные инструкции по реализации.
- SageMaker AI pricing — актуальные цены на адаптацию моделей; тариф зависит от модели и региона и может меняться.
Примечание об отчётности: проверена только документация. BIG CHANGE не получала доступ к аккаунту AWS, не отправляла и не проверяла задания SageMaker, не вызывала API AWS и не воспроизводила опубликованные метрики независимо. Руководство по реализации и результаты эксперимента опубликованы самой AWS.