A grande mudança
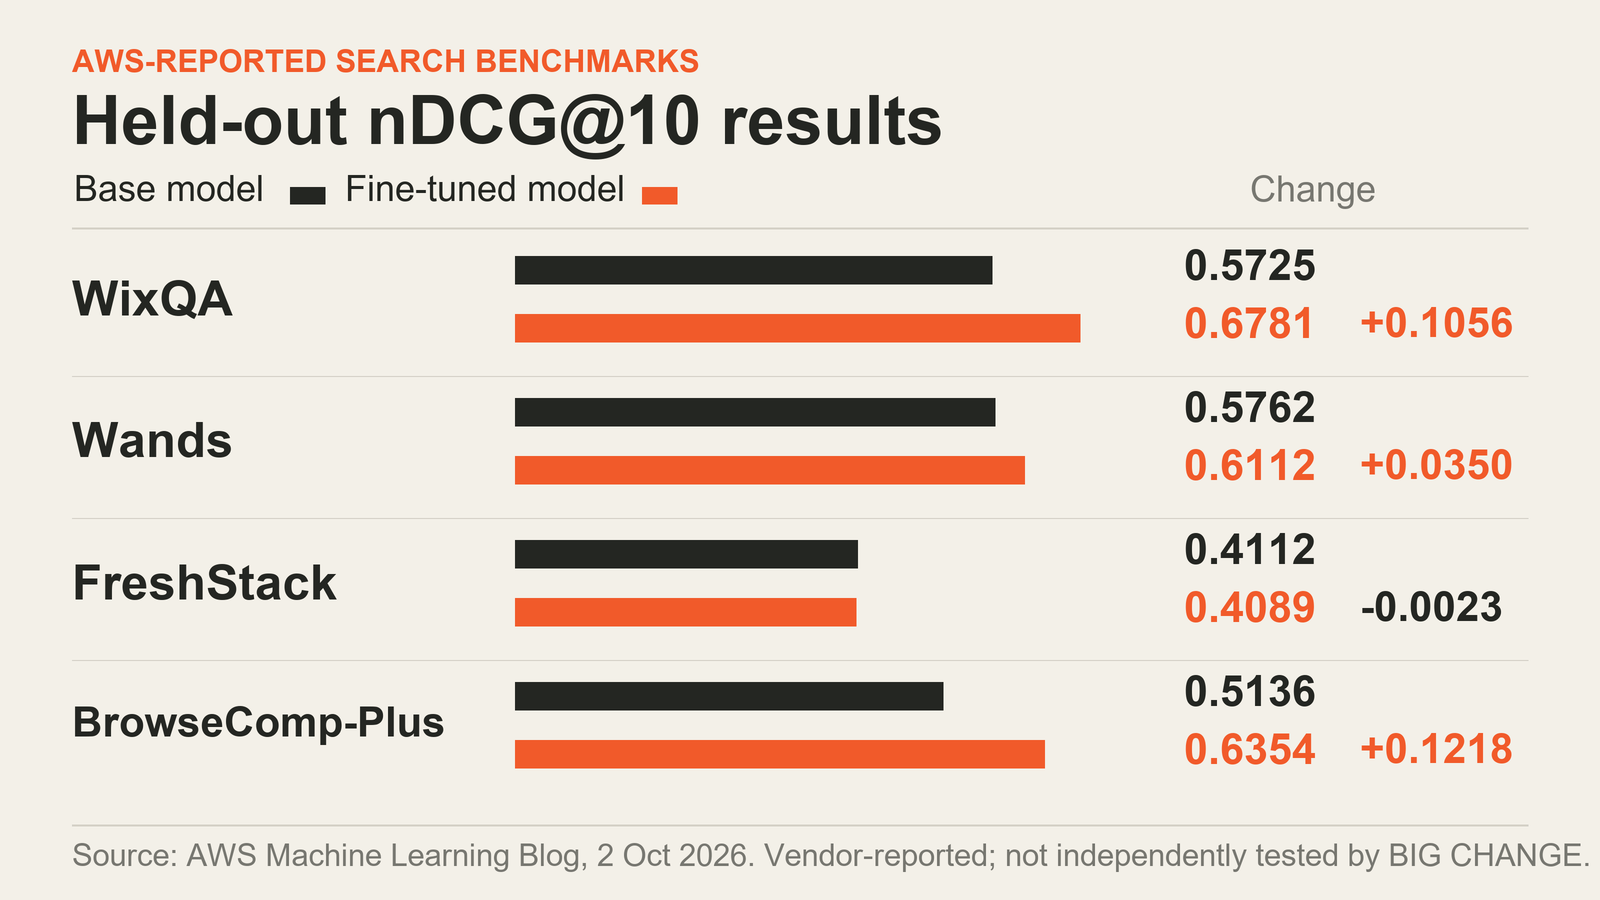
No seu guia de 2 de outubro, a AWS descreve o ajuste fino de um agente de pesquisa Qwen3.6-27B com aprendizagem por reforço multivoltas (MTRL) no SageMaker AI. O gráfico acima representa as pontuações nDCG@10 de avaliação reservada reportadas pela AWS: aumentaram em WixQA, Wands e BrowseComp-Plus e desceram ligeiramente em FreshStack. A BIG CHANGE criou o gráfico com os valores da AWS; não testámos o agente de forma independente nem reproduzimos os resultados. A técnica treina um modelo com base no resultado de uma sequência de decisões que recorrem a ferramentas.
Antes de submeter um trabalho, um engenheiro de aprendizagem automática tem de confirmar que o modelo e a região são suportados, que o agente pode participar no ciclo de execução do SageMaker, que os prompts e as recompensas representam a tarefa de pesquisa pretendida e que existe um conjunto de avaliação separado capaz de revelar regressões. Este guia baseia-se na documentação da AWS; a BIG CHANGE não executou um trabalho na AWS nem chamou as respetivas APIs.
O que o MTRL altera no ciclo de treino
No ajuste fino supervisionado, a equipa precisa de trajetórias de exemplo que demonstrem o comportamento pretendido. Na descrição da AWS para o MTRL, o SageMaker envia prompts a um agente; este chama o modelo de política e as suas ferramentas ao longo de várias interações; no fim, o agente comunica uma recompensa pela execução concluída. O modelo é atualizado com base nesse feedback. Na pesquisa, a recompensa pode avaliar a classificação final, otimizando as primeiras escolhas de consulta tendo em conta todo o episódio de pesquisa.
A distinção é importante quando as chamadas a ferramentas dependem dos resultados anteriores. Se o modelo fizer uma primeira consulta fraca, obtiver resultados pouco úteis e tiver de reformulá-la, uma recompensa no final da tarefa pode refletir se a sequência acabou por recuperar documentos relevantes. Isso não dispensa a equipa de definir o que significa “relevante” nem de criar um agente capaz de chamar as ferramentas de pesquisa da equipa.
Confirme primeiro o acesso, o modelo e a região
O exemplo de 2 de outubro foi executado na região Oeste dos EUA (Oregon), us-west-2, e ajustou o Qwen3.6-27B. A tabela de modelos suportados pelo MTRL no SageMaker, consultada em 4 de outubro de 2026, lista quatro modelos em seis combinações de modelo e região: Nova Lite 2.0 e GPT-OSS-20B na região Leste dos EUA (Norte da Virgínia), us-east-1, e Oeste dos EUA (Oregon), us-west-2; Gemma-4-31B-it e Qwen 3.6 27B apenas em Oregon. Confirme a tabela atualizada na região onde pretende criar o trabalho; um modelo constar da lista não significa que esteja disponível noutras regiões.
A equipa também precisa de uma conta AWS e de um domínio SageMaker Studio se utilizar a interface do Studio, acesso ao S3 para conjuntos de dados e resultados e funções IAM configuradas para o novo trabalho MTRL e as chamadas ao runtime. O documento de pré-requisitos da AWS diz que o utilizador que submete precisa de CreateJob e de ações de trabalho relacionadas, além de permissão para transmitir a função de execução a job.sagemaker.amazonaws.com. A função de execução precisa da política AmazonSageMakerJobFullAccess e dessa entidade de serviço na respetiva política de confiança. A função de runtime do agente precisa de AmazonSageMakerJobRuntimeAccess; um runtime AgentCore também precisa da sua própria relação de confiança. O seletor de runtime do Studio requer permissões para listar o AgentCore. Segundo a AWS, o acesso amplo preexistente ao SageMaker não inclui todas estas novas ações de trabalho.
Há dois percursos de agente documentados. Para alojamento gerido, implemente com o Bedrock AgentCore, que, segundo a AWS, funciona melhor com agentes criados com Strands; ou aloje um agente personalizado e ligue-o através de um encaminhador Lambda. O agente recebe os prompts de execução, chama o modelo de política através do runtime do trabalho no SageMaker, invoca as ferramentas de pesquisa, conclui cada execução e comunica uma recompensa. O decorador do SDK da AWS trata de grande parte desta integração; as frameworks personalizadas podem chamar diretamente as APIs do runtime. Se a função Lambda tiver um nome fora do padrão, a AWS diz que poderá ser necessário acrescentar explicitamente o respetivo ARN à política de permissões. Uma VPC ou uma chave KMS gerida pelo cliente acrescenta requisitos de configuração.
Prepare prompts e recompensas para a tarefa de pesquisa real
O guia de recursos do SageMaker aceita Parquet, JSON Lines, JSON ou CSV. Procura uma coluna chamada prompt; se não existir, recorre à primeira coluna e transmite o respetivo valor ao agente tal como está. O serviço não analisa, valida nem transforma o conteúdo dos prompts. Na pesquisa com ferramentas, o prompt pode incluir mensagens da conversa, metadados da tarefa, especificação da recompensa e configuração das ferramentas no formato esperado pelo agente. A AWS avisa que os prompts são transmitidos sem inspeção; por isso, cabe à equipa proteger os dados sensíveis. A proteção adequada deve ser integrada no armazenamento e no percurso do agente, por exemplo através de encriptação.
A recompensa é o objetivo que o modelo vai otimizar. No exemplo da AWS, usa-se nDCG@10 nos documentos recuperados no fim e atribui-se uma recompensa de -1 se o agente atingir o limite de interações ou de tokens de amostragem. É um ponto de partida concreto para uma tarefa de recuperação ordenada, mas as opções de avaliação tornam-se decisivas: a equipa precisa de rótulos de relevância fiáveis ou de outro método de pontuação defensável e deve verificar que a recompensa não favorece pequenas melhorias na classificação à custa da qualidade da resposta, da latência ou do custo das ferramentas.
A publicação no blogue diz que a mistura de treino incluía FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique e MLQA, reservando cinco por cento das instâncias de cada conjunto para validação. O conjunto de teste reservado era composto por FreshStack, WixQA, BrowseComp-Plus e Wands. Estes conjuntos públicos ou sintéticos não substituem a avaliação no corpus privado e na distribuição de consultas que a equipa pretende servir.
Submeta um trabalho pequeno e fácil de inspecionar
O artigo da AWS de 2 de outubro usa no excerto de código um import do SDK e nomes de argumentos diferentes. A referência atual do trabalho de treino no SageMaker apresenta a seguinte estrutura de API para um runtime Bedrock AgentCore. Este exemplo usa o identificador de modelo GPT-OSS-20B atualmente documentado pela AWS; escolha um modelo disponível na região pretendida e confirme a tabela de modelos suportados atualizada antes de o adaptar. O exemplo atual também exige um ARN de aplicação MLflow, um ARN de função e a aceitação do EULA.
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
Este é o exemplo atual da documentação da AWS, não um comando testado pela BIG CHANGE. O artigo de 2 de outubro da AWS apresenta um sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri e output_s3_uri diferentes. Como não coincidem com o guia atual do trabalho, siga a referência atual para uma nova implementação e confirme a versão do SDK e os requisitos do modelo no seu ambiente. Não apurámos se o exemplo do blogue reflete uma versão anterior do SDK ou uma inconsistência na documentação. A interface do Studio é outro percurso documentado para submeter: escolha um modelo JumpStart suportado, selecione Multi-Turn Reinforcement Learning, configure o runtime AgentCore ou o encaminhador Lambda, indique os dados de treino e submeta.
Na primeira execução, registe o modelo, a região, a versão do conjunto de dados, a recompensa, os limites, os hiperparâmetros e o caminho de saída para poder comparar uma avaliação posterior com a mesma referência. Se utilizar uma VPC gerida pelo cliente, o guia de VPC da AWS especifica sub-redes privadas em duas zonas de disponibilidade e endpoints de VPC para S3 e CloudWatch Logs, além de um endpoint AgentCore ou Lambda, conforme aplicável; se utilizar MLflow, também precisa de um endpoint para esse serviço. A função de execução precisa de permissões para gerir interfaces de rede. O percurso opcional com uma chave KMS gerida pelo cliente exige permissões adicionais e configuração da política da chave para o utilizador, a função de execução e o runtime; por predefinição, os dados em repouso são encriptados com KMS da AWS. Consulte os guias de VPC e de encriptação antes de usar qualquer uma destas configurações. Antes de submeter, consulte as quotas da conta: por predefinição, a AWS permite um trabalho de ajuste fino MTRL e um trabalho de avaliação em simultâneo; é possível pedir o aumento de ambos através do Service Quotas. Os limites de chamadas às APIs de gestão de trabalhos não podem ser alterados.
Avalie com prompts reservados antes da implementação
A documentação de avaliação da AWS recomenda manter os prompts de avaliação fora do treino, usar o mesmo formato de prompt, abranger as ferramentas e combinações de ferramentas importantes, incluir casos anteriormente problemáticos e proteger conteúdo sensível. O avaliador do SageMaker pode executar um modelo candidato com um conjunto de prompts e comunicar a recompensa, pass@k e métricas das trajetórias. A documentação mostra como avaliar um modelo ajustado e, opcionalmente, incluir o modelo base no mesmo processo comparativo.
Defina o protocolo de avaliação antes do treino. Mantenha um conjunto fixo de prompts reservados que represente as consultas, as permissões e as alterações nos documentos que o agente encontrará em produção. Compare os modelos base e ajustado com as mesmas ferramentas, limites e código de pontuação. Analise não só a pontuação média de recuperação, mas também as falhas das tarefas, o número de interações, a latência, o uso de tokens e os casos em que documentos relevantes desaparecem das primeiras posições. A documentação explica como submeter um trabalho de avaliação da AWS; não demonstra que uma única métrica represente a qualidade da pesquisa em produção.
A publicação da AWS apresenta estes resultados de avaliação reservada:
Conjunto de dados (perguntas) | nDCG@10 base | nDCG@10 ajustado | Taxa de falha base | Taxa de falha ajustada |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
A tabela mostra aumentos de nDCG@10 em três conjuntos e uma pequena descida em FreshStack. A AWS atribui a menor taxa de falha em BrowseComp-Plus à penalização por atingir o limite de interações ou tokens. O artigo não apresenta intervalos de confiança nem uma análise de significância estatística junto dos valores. Refere também que o modelo ajustado teve, em média, 4.5 contra 4.3 interações em WixQA e 2.9 contra 2.2 em Wands; portanto, não houve uma redução universal do número de interações. Considere isto uma experiência reportada pelo fornecedor, não uma validação independente nem prova de que outro corpus terá melhorias.
Orçamente o ensaio completo
A documentação do MTRL da AWS identifica três componentes de custo de treino: tokens de prefill processados como entrada, tokens de amostragem gerados durante as execuções e atualizações do treino. A página de preços apresenta tarifas específicas para cada modelo; essas tarifas, o volume de execuções, o comprimento das sequências, as épocas e o runtime determinam a estimativa. O artigo de exemplo não publica a fatura total e a documentação não fornece um preço universal para um ensaio. Consulte a tarifa atual do modelo e da região escolhidos e estime com base na utilização prevista do trabalho, em vez de assumir um custo fixo.
Inclua os custos associados na estimativa: armazenamento e pedidos no S3 para dados de treino, validação, checkpoints e artefactos de saída; o runtime AgentCore ou Lambda e qualquer infraestrutura de pesquisa de apoio durante as execuções; registos e MLflow; avaliação reservada; e qualquer endpoint ou implementação Bedrock usados após o treino. A publicação da AWS recomenda especificamente parar ou eliminar um trabalho MTRL em execução, apagar artefactos de modelo desnecessários no S3 e remover endpoints de avaliação para evitar cobranças contínuas. A implementação num endpoint é uma decisão e uma categoria de custo separadas do treino.
Decida se deve avançar
Este fluxo de trabalho é mais relevante quando a tarefa de pesquisa exige várias chamadas dependentes a ferramentas e a equipa consegue pontuar o resultado final. Um ensaio só é útil para a tomada de decisão se tiver um par modelo-região suportado, integração funcional do agente, dados de prompts representativos, uma recompensa que reflita a tarefa, uma comparação reservada e uma estimativa de custos que inclua os serviços associados. Um resultado forte nos quatro benchmarks da AWS é motivo para examinar o método, não para presumir o mesmo efeito noutro índice, conjunto de consultas ou limite de permissões.
Fontes e leituras adicionais
- Blogue AWS Machine Learning: “Ajuste fino de um agente de pesquisa com RL multivoltas no Amazon SageMaker AI” (2 de outubro de 2026) — guia do fornecedor sobre implementação, configuração, escolha de dados e resultados de avaliação reportados.
- Amazon SageMaker AI: aprendizagem por reforço multivoltas — modelos e regiões atualmente suportados e componentes de faturação.
- Pré-requisitos, Preparar o agente, Configuração da VPC e encriptação em repouso — permissões, opções de runtime, integração e configuração opcional de rede e encriptação.
- Criar recursos, submeter um trabalho de treino, avaliação, hiperparâmetros e quotas — referências atuais de implementação.
- Preços do SageMaker AI — preços atuais da personalização de modelos; as tarifas variam por modelo e região.
Nota metodológica: apenas análise da documentação. A BIG CHANGE não acedeu a uma conta AWS, não submeteu nem inspecionou um trabalho no SageMaker, não chamou APIs da AWS nem reproduziu os valores reportados de forma independente. A AWS escreveu o guia de implementação e reporta a sua própria experiência.