মূল পরিবর্তন
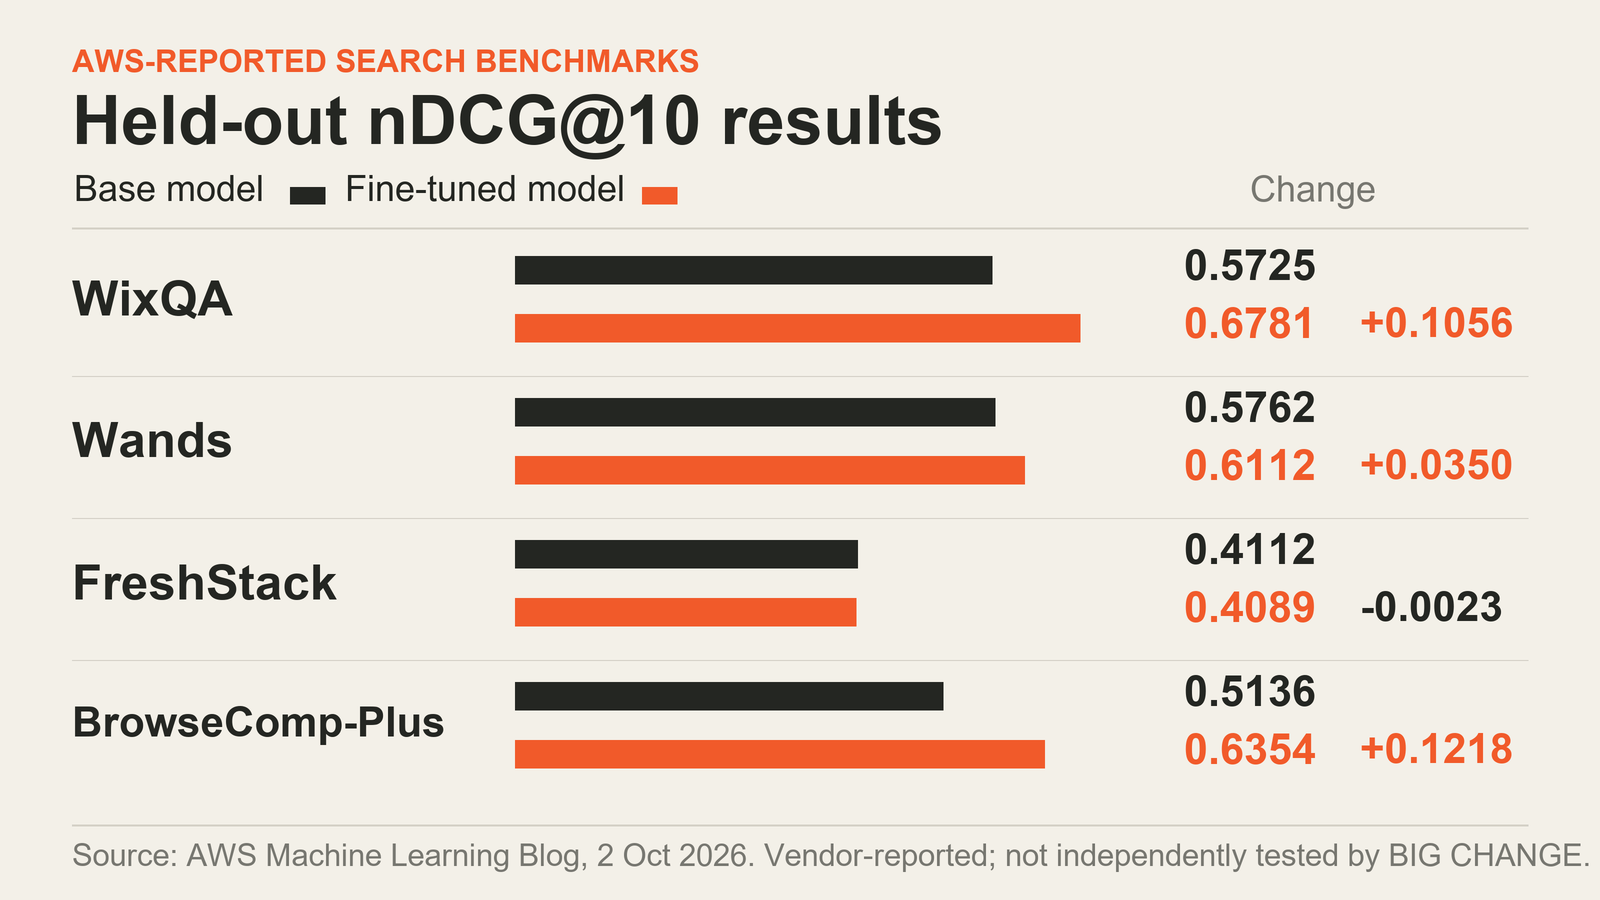
নিজের ২ অক্টোবরের নির্দেশিকায়, AWS SageMaker AI-তে মাল্টি-টার্ন রিইনফোর্সমেন্ট লার্নিং (MTRL) দিয়ে Qwen3.6-27B সার্চ এজেন্ট ফাইন-টিউন করার পদ্ধতি বর্ণনা করেছে। উপরের চার্টে AWS-এর জানানো হোল্ডআউট nDCG@10 স্কোর দেখানো হয়েছে: WixQA, Wands এবং BrowseComp-Plus-এ স্কোর বেড়েছে, FreshStack-এ সামান্য কমেছে। AWS-এর পরিসংখ্যান থেকে BIG CHANGE চার্টটি তৈরি করেছে; আমরা স্বাধীনভাবে এজেন্ট পরীক্ষা করিনি বা ফলাফল পুনরুৎপাদন করিনি। এই কৌশলে টুল-ব্যবহারকারী সিদ্ধান্তের ধারাবাহিকতার ফলের ভিত্তিতে মডেলকে প্রশিক্ষণ দেওয়া হয়।
কোনো জব জমা দেওয়ার আগে মেশিন লার্নিং ইঞ্জিনিয়ারকে নিশ্চিত করতে হবে যে মডেল ও অঞ্চল সমর্থিত, এজেন্ট SageMaker rollout loop-এ অংশ নিতে পারে, prompt ও reward নির্দিষ্ট সার্চ কাজকে উপস্থাপন করে এবং আলাদা মূল্যায়ন সেট কর্মক্ষমতার অবনতি ধরতে পারে। এই নির্দেশিকা AWS-এর নথির ওপর ভিত্তি করে তৈরি; BIG CHANGE AWS জব চালায়নি বা এর API কল করেনি।
প্রশিক্ষণ চক্রে MTRL কী বদলায়
Supervised fine-tuning-এর জন্য কাঙ্ক্ষিত আচরণ দেখানো উদাহরণ trajectory লাগে। AWS-এর MTRL বর্ণনায় SageMaker তার বদলে এজেন্টকে prompt পাঠায়; একাধিক ধাপে এজেন্ট policy model ও তার টুল কল করে, আর rollout সম্পূর্ণ হলে reward জানায়। সেই feedback ব্যবহার করে মডেল আপডেট হয়। সার্চের ক্ষেত্রে reward চূড়ান্ত ranking-কে স্কোর করতে পারে, ফলে প্রথম দিকের query নির্বাচন পুরো সার্চ পর্বের প্রেক্ষিতে অপ্টিমাইজ হয়।
টুল কল আগের ফলাফলের ওপর নির্ভর করলে এই পার্থক্যটি গুরুত্বপূর্ণ। মডেল প্রথম query খারাপ করলে, দুর্বল ফল পেলে এবং সেটি নতুনভাবে সাজাতে হলে, কাজের শেষে দেওয়া reward দিয়ে বোঝা যেতে পারে ধারাবাহিক ধাপগুলি শেষ পর্যন্ত প্রাসঙ্গিক নথি উদ্ধার করেছে কি না। তবে ‘প্রাসঙ্গিক’ বলতে কী বোঝায় তা নির্ধারণ করতে হবে এবং টিমের সার্চ টুল কল করতে পারে এমন এজেন্ট বানাতে হবে।
আগে অ্যাক্সেস, মডেল ও অঞ্চল যাচাই করুন
২ অক্টোবরের উদাহরণটি US West (Oregon) অঞ্চলে চালানো হয়েছিল, us-west-2, এবং এতে Qwen3.6-27B ফাইন-টিউন করা হয়। SageMaker MTRL-এ সমর্থিত মডেলের তালিকা, ৪ অক্টোবর ২০২৬-এ যাচাই করা তালিকায় চারটি মডেলের ছয়টি মডেল-অঞ্চল জুটি রয়েছে: Nova Lite 2.0 এবং GPT-OSS-20B US East (N. Virginia)-তে, us-east-1, এবং US West (Oregon)-এ, us-west-2; Gemma-4-31B-it এবং Qwen 3.6 27B শুধু Oregon-এ সমর্থিত। যেখানে জব তৈরি করবেন সেই অঞ্চলের হালনাগাদ তালিকা দেখুন; তালিকায় মডেলের নাম থাকলেই অন্য অঞ্চলে সেটি পাওয়া যাবে এমন নয়।
Studio ইন্টারফেস ব্যবহার করলে টিমের AWS অ্যাকাউন্ট ও SageMaker Studio domain-ও প্রয়োজন। ডেটাসেট ও আউটপুটের জন্য S3 অ্যাক্সেস এবং নতুন MTRL জব ও runtime call-এর জন্য কনফিগার করা IAM role লাগে। AWS-এর prerequisites নথি অনুসারে, কলকারীকে CreateJob এবং সংশ্লিষ্ট জব অ্যাকশনের অনুমতি নিতে হবে; execution role-টি job.sagemaker.amazonaws.com-এ pass করার অনুমতিও লাগবে। Execution role-এর দরকার AmazonSageMakerJobFullAccess policy এবং trust policy-তে ওই service principal। এজেন্ট runtime role-এর দরকার AmazonSageMakerJobRuntimeAccess; AgentCore runtime-এর নিজস্ব trust relationship-ও দরকার। Studio-র runtime picker-এ AgentCore তালিকাভুক্ত করতে অনুমতি লাগে। AWS বলেছে, আগে থেকে থাকা বিস্তৃত SageMaker অ্যাক্সেসেই এসব নতুন জব অ্যাকশন সব অন্তর্ভুক্ত হয় না।
নথিতে এজেন্ট চালানোর দুটি পথ আছে। Managed hosting-এর জন্য Bedrock AgentCore-এ deploy করুন—AWS বলেছে Strands দিয়ে তৈরি এজেন্টের ক্ষেত্রে এটি সবচেয়ে ভালো কাজ করে—অথবা নিজস্ব এজেন্ট host করে Lambda forwarder দিয়ে যুক্ত করুন। এজেন্ট rollout prompt পায়, SageMaker job runtime দিয়ে policy model কল করে, সার্চ টুল চালায়, প্রতিটি rollout শেষ করে এবং reward জানায়। AWS SDK decorator এই একীভবনের বড় অংশ সামলায়; custom framework সরাসরি runtime API কল করতে পারে। Lambda function-এর নাম প্রচলিত ধাঁচের না হলে, AWS-এর মতে permission policy-তে তার ARN স্পষ্টভাবে যোগ করতে হতে পারে। Customer-managed VPC বা KMS key নিলে অতিরিক্ত সেটআপ লাগে।
বাস্তব সার্চ কাজের জন্য prompt ও reward তৈরি করুন
SageMaker asset নির্দেশিকা Parquet, JSON Lines, JSON বা CSV গ্রহণ করে। এটি prompt নামের column খোঁজে; সেটি না থাকলে প্রথম column ব্যবহার করে সেই মান অপরিবর্তিতভাবে এজেন্টকে দেয়। সার্ভিস prompt content parse, validate বা transform করে না। টুল-ব্যবহারকারী সার্চে prompt-এ কথোপকথনের বার্তা, কাজের metadata, reward specification ও এজেন্টের প্রত্যাশিত format-এ tool configuration থাকতে পারে। AWS সতর্ক করেছে, prompt যাচাই ছাড়াই পাঠানো হয়; তাই সংবেদনশীল ডেটা রক্ষার দায় টিমের। স্টোরেজ ও এজেন্টের পথে encryption বা অন্য উপযুক্ত সুরক্ষা রাখুন।
Reward হলো মডেলের অপ্টিমাইজ করার লক্ষ্য। AWS-এর উদাহরণে চূড়ান্তভাবে উদ্ধার করা নথিতে nDCG@10 ব্যবহার করা হয়েছে এবং এজেন্ট turn বা sampling-token সীমায় পৌঁছালে -1 reward দেওয়া হয়। Ranked retrieval কাজের জন্য এটি একটি নির্দিষ্ট সূচনা, তবে এতে মূল্যায়নের সিদ্ধান্ত গুরুত্বপূর্ণ হয়ে ওঠে: নির্ভরযোগ্য relevance label বা স্কোরিংয়ের অন্য কোনো সমর্থনযোগ্য পদ্ধতি দরকার। Reward যেন উপরিভাগের ranking উন্নত করতে গিয়ে উত্তরের মান, latency বা টুলের খরচ খারাপ না করে, সেটিও যাচাই করুন।
ব্লগ পোস্টে বলা হয়েছে, প্রশিক্ষণের মিশ্রণে FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique এবং MLQA ছিল; প্রতিটি dataset-এর প্রশিক্ষণ উদাহরণের পাঁচ শতাংশ validation-এর জন্য রাখা হয়েছিল। হোল্ডআউট test set-এ ছিল FreshStack, WixQA, BrowseComp-Plus এবং Wands। এসব প্রকাশ্য বা synthetic dataset যে ব্যক্তিগত corpus ও query বণ্টনে টিম পরিষেবা দিতে চায়, সেখানে মূল্যায়নের বিকল্প নয়।
ছোট ও সহজে পরীক্ষা করা যায় এমন জব জমা দিন
ওই ২ অক্টোবরের AWS ব্লগে code snippet-এর জন্য ভিন্ন SDK import ও argument name ব্যবহার করা হয়েছে। বর্তমান SageMaker training-job reference Bedrock AgentCore runtime-এর জন্য API-র এই ধরন দেখায়। উদাহরণে AWS নথিতে থাকা বর্তমান GPT-OSS-20B model identifier ব্যবহার করা হয়েছে। লক্ষ্য অঞ্চলে পাওয়া যায় এমন মডেল বেছে নিন এবং উদাহরণ বদলানোর আগে সমর্থিত মডেলের হালনাগাদ তালিকা দেখুন। বর্তমান উদাহরণে MLflow app ARN, role ARN এবং EULA গ্রহণও প্রয়োজন।
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
এটি AWS-এর বর্তমান নথির উদাহরণ, BIG CHANGE-এর পরীক্ষা করা command নয়। ২ অক্টোবরের AWS ব্লগে ভিন্ন sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri এবং output_s3_uri argument রয়েছে। এগুলি বর্তমান job guide-এর সঙ্গে মেলে না বলে নতুন বাস্তবায়নে বর্তমান reference অনুসরণ করুন এবং নিজের পরিবেশে SDK version ও মডেলের শর্ত যাচাই করুন; ব্লগের উদাহরণ পুরোনো SDK revision থেকে এসেছে নাকি নথিতে অসঙ্গতি আছে তা আমরা নির্ধারণ করিনি। Studio UI-ও নথিভুক্ত submission পথ: সমর্থিত JumpStart model বেছে নিন, Multi-Turn Reinforcement Learning নির্বাচন করুন, AgentCore runtime বা Lambda forwarder সেট করুন, training data দিন এবং জমা দিন।
প্রথমবার চালানোর সময় মডেল, অঞ্চল, dataset version, reward, সীমা, hyperparameter ও output path লিখে রাখুন, যাতে পরের মূল্যায়ন একই baseline-এর সঙ্গে তুলনা করা যায়। Customer-managed VPC ব্যবহার করলে AWS-এর আলাদা VPC guide-এ দুই Availability Zone-এ private subnet, S3 ও CloudWatch Logs-এর VPC endpoint এবং প্রযোজ্য ক্ষেত্রে AgentCore বা Lambda endpoint নির্দিষ্ট করা আছে; MLflow ব্যবহার করলেও endpoint দরকার। Execution role-এর ENI পরিচালনার অনুমতি লাগে। ঐচ্ছিক customer-managed KMS ব্যবস্থায় কলকারী, execution role ও runtime-এর জন্য অতিরিক্ত অনুমতি এবং key-policy সেটআপ দরকার; ডিফল্টভাবে স্থিত ডেটা AWS-owned KMS key দিয়ে encrypt হয়। যেকোনো ব্যবস্থা নেওয়ার আগে VPC ও encryption guide পড়ুন। জমা দেওয়ার আগে account quota দেখুন: ডিফল্ট হিসেবে AWS একসঙ্গে একটি MTRL fine-tuning job এবং একটি evaluation job তালিকাভুক্ত করে; Service Quotas দিয়ে দুটিই বদলানো যায়। Job-management API throttling limit বদলানো যায় না।
Deploy করার আগে হোল্ডআউট prompt-এ মূল্যায়ন করুন
AWS-এর evaluation নথি বলে, evaluation prompt প্রশিক্ষণের বাইরে রাখতে হবে, একই prompt format ব্যবহার করতে হবে, গুরুত্বপূর্ণ টুল ও তাদের সমন্বয় অন্তর্ভুক্ত করতে হবে, আগে ব্যর্থ হওয়া কেস যোগ করতে হবে এবং সংবেদনশীল বিষয়বস্তু সুরক্ষিত রাখতে হবে। SageMaker evaluator prompt set-এ candidate চালিয়ে reward, pass@k এবং trajectory metric জানাতে পারে। নথিতে fine-tuned model মূল্যায়ন এবং ঐচ্ছিকভাবে একই comparison pipeline-এ base model মূল্যায়নের কথাও আছে।
প্রশিক্ষণের আগে evaluation protocol স্থির করুন। live agent যে query, permission ও নথির পরিবর্তন পাবে তা প্রতিফলিত করে এমন একটি স্থির হোল্ডআউট সেট রাখুন। একই টুল, সীমা ও scoring code দিয়ে base ও fine-tuned model তুলনা করুন। শুধু গড় retrieval score নয়, task failure, turn-এর সংখ্যা, latency, token ব্যবহার এবং প্রাসঙ্গিক নথি শীর্ষ ফল থেকে বাদ পড়ার ঘটনাও দেখুন। AWS evaluation job কীভাবে জমা দিতে হয় তা নথিতে আছে; কোনো একক metric উৎপাদন পর্যায়ের সার্চের মান সম্পূর্ণভাবে ধরে—এটি নথি প্রমাণ করে না।
AWS-এর পোস্টে এই হোল্ডআউট ফল জানানো হয়েছে:
Dataset (প্রশ্ন) | Base nDCG@10 | Fine-tuned nDCG@10 | Base failure rate | Fine-tuned failure rate |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
তালিকায় nDCG@10 তিনটি বেড়েছে এবং FreshStack-এ সামান্য কমেছে। turn বা token সীমায় পৌঁছানোর জন্য দেওয়া penalty-কে BrowseComp-Plus-এর কম failure rate-এর কারণ বলে AWS জানায়। এই সংখ্যার সঙ্গে ব্লগে confidence interval বা statistical significance analysis নেই। WixQA-তে fine-tuned model গড়ে 4.5 বনাম 4.3 turn এবং Wands-এ 2.9 বনাম 2.2 turn ব্যবহার করেছে বলেও জানানো হয়েছে; তাই সব ক্ষেত্রে turn কমেনি। এটিকে vendor-প্রতিবেদিত পরীক্ষা হিসেবে দেখুন, স্বাধীন যাচাই বা অন্য corpus-এ উন্নতির প্রমাণ হিসেবে নয়।
পুরো পরীক্ষার খরচ ধরুন
AWS-এর MTRL নথিতে প্রশিক্ষণের তিনটি চার্জের মাত্রা আছে: input হিসেবে process হওয়া prefill token, rollout চলাকালে তৈরি sampled token এবং training update। মূল্যতালিকায় মডেলভিত্তিক হার আছে; সেই হার, rollout-এর পরিমাণ, sequence length, epoch ও runtime মিলে খরচ নির্ধারণ করে। উদাহরণ নিবন্ধে মোট বিল প্রকাশ করা হয়নি এবং নথিতে সর্বজনীন কোনো পরীক্ষার মূল্যও নেই। নির্বাচিত মডেল ও অঞ্চলের বর্তমান হার দেখুন, নির্দিষ্ট খরচ ধরে না নিয়ে সম্ভাব্য job ব্যবহারের ভিত্তিতে হিসাব করুন।
হিসাবে সংশ্লিষ্ট খরচও ধরুন: training, validation, checkpoint ও output artifact-এর জন্য S3 storage ও request; rollout-এর সময় AgentCore runtime বা Lambda এবং সহায়ক সার্চ পরিকাঠামো; logging ও MLflow; হোল্ডআউট মূল্যায়ন; প্রশিক্ষণের পর ব্যবহৃত endpoint বা Bedrock deployment। চলমান MTRL job থামানো বা মুছে ফেলা, অপ্রয়োজনীয় S3 model artifact সরানো এবং evaluation endpoint মুছে ফেলার পরামর্শ AWS-এর পোস্টে বিশেষভাবে দেওয়া হয়েছে, যাতে খরচ চলতে না থাকে। Endpoint deployment প্রশিক্ষণ থেকে আলাদা সিদ্ধান্ত ও খরচের খাত।
এগোনো উচিত কি না ঠিক করুন
যে সার্চ কাজে একাধিক নির্ভরশীল tool call লাগে এবং টিম চূড়ান্ত ফল স্কোর করতে পারে, সেখানে এই workflow সবচেয়ে প্রাসঙ্গিক। সমর্থিত model-region জুটি, কার্যকর agent integration, প্রতিনিধিত্বমূলক prompt data, কাজের উপযোগী reward, হোল্ডআউট তুলনা এবং পার্শ্ববর্তী পরিষেবাসহ খরচের হিসাব থাকলেই পরীক্ষা সিদ্ধান্তে কাজে লাগে। AWS-এর চার benchmark-এ ভালো ফল পদ্ধতিটি খতিয়ে দেখার কারণ, অন্য index, query mix বা permission boundary-তেও একই ফল হবে ধরে নেওয়ার নয়।
সূত্র ও আরও পড়ুন
- AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (২ অক্টোবর ২০২৬) — vendor-এর নির্দেশিকা, সেটআপ, dataset বাছাই এবং জানানো মূল্যায়নের ফল।
- Amazon SageMaker AI: Multi-turn reinforcement learning — বর্তমানে সমর্থিত মডেল ও অঞ্চল, workflow-এর সারাংশ এবং প্রশিক্ষণ-চার্জের মাত্রা।
- পূর্বশর্ত, আপনার এজেন্ট প্রস্তুত করুন, VPC কনফিগারেশন এবং স্থির অবস্থায় encryption — অনুমতি, runtime-এর বিকল্প, integration এবং ঐচ্ছিক নেটওয়ার্ক ও encryption সেটআপ।
- asset তৈরি, training job জমা, evaluation, hyperparameter এবং quota — বাস্তবায়নের বর্তমান নির্দেশনা।
- SageMaker AI-এর মূল্য — model customization-এর বর্তমান মূল্যবিবরণ; মডেল ও অঞ্চলভেদে হার বদলায়।
প্রতিবেদন-সংক্রান্ত নোট: শুধু নথি পর্যালোচনা করা হয়েছে। BIG CHANGE কোনো AWS অ্যাকাউন্টে প্রবেশ করেনি, SageMaker job জমা বা পরীক্ষা করেনি, AWS API কল করেনি এবং জানানো metric স্বাধীনভাবে পুনরুৎপাদন করেনি। বাস্তবায়ন নির্দেশিকা AWS লিখেছে এবং নিজেদের পরীক্ষার ফল তারাই জানিয়েছে।