التغيير الأبرز
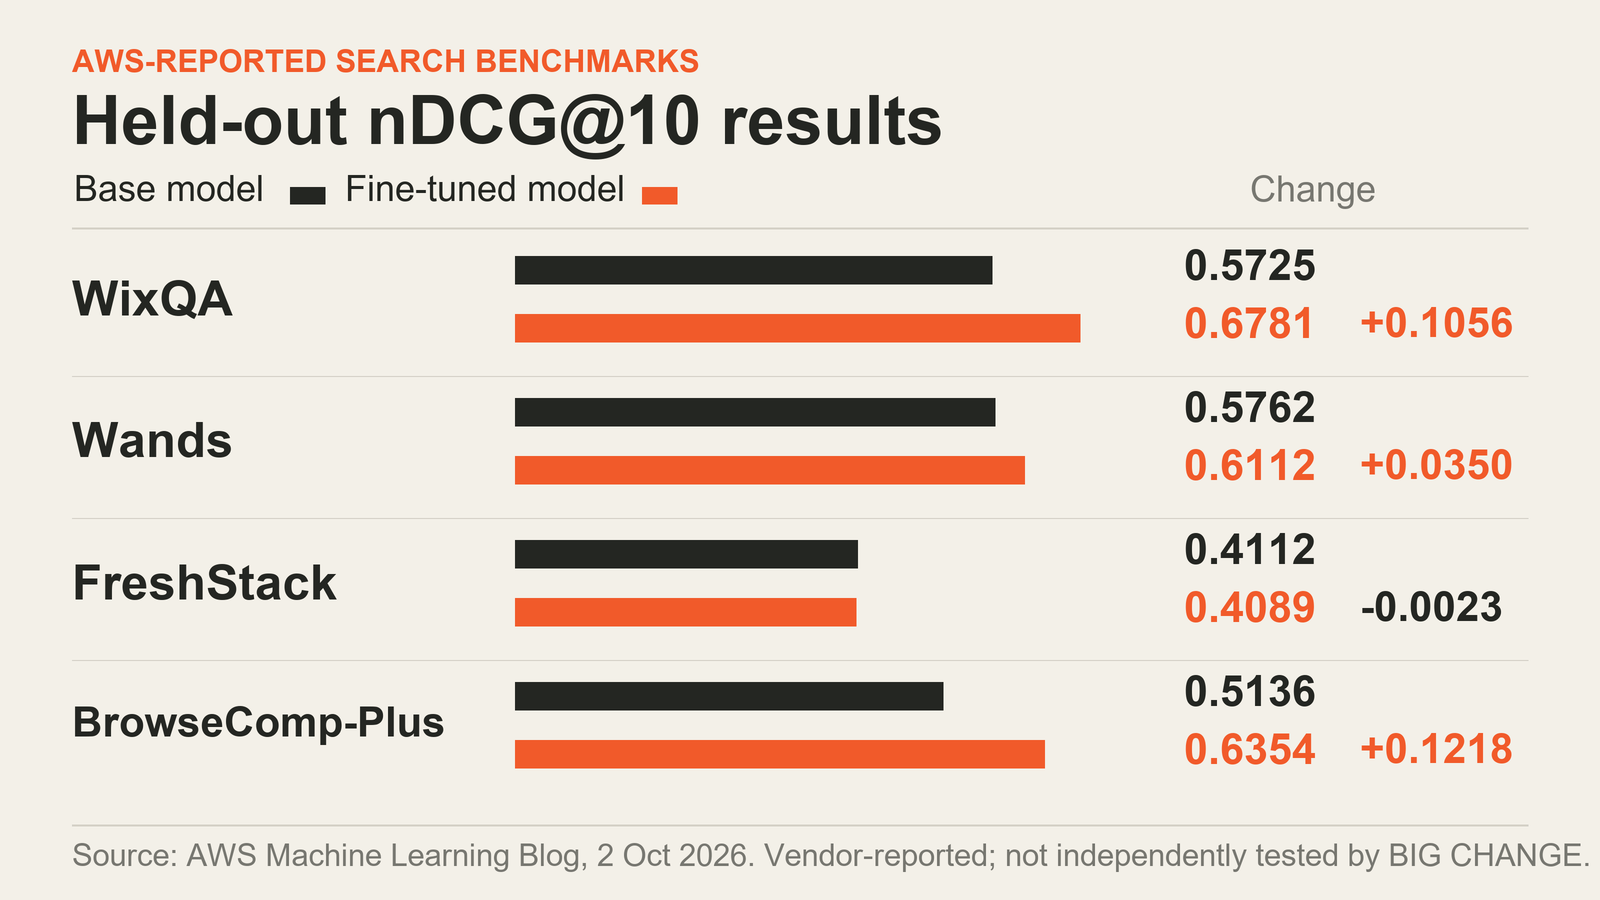
في جولة الشرح في 2 أكتوبر، تصف AWS ضبط وكيل بحث Qwen3.6-27B باستخدام التعلّم المعزّز متعدد الأدوار (MTRL) في SageMaker AI. يعرض الرسم البياني أعلاه درجات nDCG@10 المحجوبة التي أبلغت عنها AWS: ارتفعت في WixQA وWands وBrowseComp-Plus، وانخفضت قليلاً في FreshStack. أعدّت BIG CHANGE الرسم من أرقام AWS؛ ولم نختبر الوكيل على نحو مستقل أو نكرر النتائج. وتدرّب هذه التقنية نموذجاً بالاستناد إلى نتيجة سلسلة من القرارات التي تستخدم الأدوات.
قبل إرسال مهمة، يحتاج مهندس تعلّم آلي إلى التحقق من دعم النموذج والمنطقة، وقدرة الوكيل على المشاركة في حلقة التنفيذ المرحلي في SageMaker، وتمثيل المطالبات والمكافآت لمهمة البحث المقصودة، وقدرة مجموعة تقييم منفصلة على كشف التراجعات. يستند هذا الدليل إلى وثائق AWS؛ ولم نشغّل مهمة على AWS أو نستدع واجهاتها البرمجية.
ما الذي يغيّره MTRL في حلقة التدريب
في الضبط الدقيق الخاضع للإشراف، يحتاج الفريق إلى مسارات أمثلة توضّح السلوك المطلوب. أما في وصف AWS لـ MTRL، فترسل SageMaker المطالبات إلى وكيل، ويستدعي الوكيل نموذج السياسة وأدواته عبر أدوار متعددة، ثم يبلّغ عن مكافأة للتنفيذ المرحلي المكتمل. ويُحدَّث النموذج استناداً إلى هذه الملاحظات. وفي البحث، يمكن للمكافأة تقييم الترتيب النهائي، بحيث تُحسَّن اختيارات الاستعلام المبكرة في سياق جلسة البحث بأكملها.
يكتسب هذا الفرق أهمية عندما تعتمد استدعاءات الأدوات على نتائج سابقة. فإذا بدأ النموذج باستعلام ضعيف، ورأى نتائج غير جيدة، وكان ينبغي له إعادة صياغة الاستعلام، أمكن لمكافأة نهاية المهمة أن تعكس ما إذا كانت السلسلة قد استرجعت في نهاية المطاف وثائق ذات صلة. لكنها لا تلغي الحاجة إلى تعريف معنى «ذات صلة» أو بناء وكيل يستطيع استدعاء أدوات البحث الخاصة بالفريق.
تحقق من الوصول والنموذج والمنطقة أولاً
نُفّذ مثال 2 أكتوبر في منطقة US West (Oregon)، us-west-2، وضُبط فيه نموذج Qwen3.6-27B. ويعرض جدول النماذج المدعومة لـ SageMaker MTRL، الذي جرت مراجعته في 4 أكتوبر 2026، أربعة نماذج ضمن ستة أزواج من النموذج والمنطقة: Nova Lite 2.0 وGPT-OSS-20B في US East (N. Virginia)، us-east-1، وUS West (Oregon)، us-west-2؛ أما Gemma-4-31B-it وQwen 3.6 27B فمتاحان في Oregon فقط. تحقّق من الجدول الحالي في المنطقة التي تنوي إنشاء المهمة فيها؛ فإدراج نموذج في القائمة لا يثبت توافره في مناطق أخرى.
يحتاج الفريق أيضاً إلى حساب AWS ونطاق SageMaker Studio إذا كان سيستخدم واجهة Studio، وإمكانية الوصول إلى S3 لمجموعات البيانات والمخرجات، وأدوار IAM مهيأة لمهمة MTRL الجديدة واستدعاءات وقت التشغيل. وتقول وثيقة المتطلبات المسبقة لدى AWS إن على المستدعي امتلاك CreateJob والإجراءات المرتبطة بالمهمة، إضافة إلى إذن تمرير دور التنفيذ إلى job.sagemaker.amazonaws.com. ويحتاج دور التنفيذ إلى سياسة AmazonSageMakerJobFullAccess وإضافة مبدأ الخدمة هذا إلى سياسة الثقة. أما دور وقت تشغيل الوكيل فيحتاج إلى AmazonSageMakerJobRuntimeAccess؛ كما يحتاج وقت تشغيل AgentCore إلى علاقة ثقة خاصة به. وتحتاج قائمة اختيار وقت التشغيل في Studio إلى أذونات عرض AgentCore. ووفقاً لـ AWS، لا يشمل الوصول العام القائم إلى SageMaker وحده كل إجراءات المهام الجديدة هذه.
توجد طريقتان موثقتان لإعداد الوكيل. يمكن نشره عبر Bedrock AgentCore لاستضافته المُدارة، وهو ما تقول AWS إنه الأنسب للوكلاء المبنيين باستخدام Strands، أو استضافة وكيل مخصص وربطه عبر مُمرِّر Lambda. يتلقى الوكيل مطالبات التنفيذ المرحلي، ويستدعي نموذج السياسة عبر وقت تشغيل المهمة في SageMaker، ويستخدم أدوات البحث، ويكمل كل تنفيذ مرحلي، ثم يبلّغ عن مكافأة. ويتولى مزخرف SDK من AWS جانباً كبيراً من هذا الربط؛ كما يمكن للأطر المخصصة استدعاء واجهات وقت التشغيل مباشرة. وإذا استخدمت دالة Lambda اسماً غير نمطي، فتقول AWS إن ARN الخاص بها قد يحتاج إلى إضافته صراحةً إلى سياسة الأذونات. وتضيف شبكة VPC أو مفتاح KMS يديرهما العميل متطلبات إعداد أخرى.
أعدّ المطالبات والمكافأة لمهمة البحث الفعلية
يقبل دليل أصول SageMaker تنسيقات Parquet وJSON Lines وJSON وCSV. ويبحث عن عمود باسم prompt؛ وإذا لم يجده، يستخدم العمود الأول، ثم يمرر قيمته إلى الوكيل كما هي. ولا تحلل الخدمة محتوى المطالبات أو تتحقق منه أو تحوّله. ويمكن أن تتضمن المطالبة، في البحث المعتمد على الأدوات، رسائل المحادثة وبيانات وصفية للمهمة ومواصفات للمكافأة وإعدادات للأدوات بالصيغة التي يتوقعها الوكيل. وتحذر AWS من أن المطالبات تمر من دون فحص، لذا تظل حماية البيانات الحساسة مسؤولية الفريق؛ وينبغي تصميم التشفير أو وسيلة حماية مناسبة أخرى ضمن التخزين ومسار الوكيل.
المكافأة هي الهدف الذي سيحسّنه النموذج. يستخدم مثال AWS مقياس nDCG@10 للوثائق المسترجعة نهائياً، ويمنح مكافأة قدرها -1 عندما يبلغ الوكيل حد الأدوار أو حد الرموز المأخوذة بالاستدلال. وهذا تصميم مبدئي ملموس لمهمة استرجاع مرتبة، لكنه يجعل خيارات التقييم مؤثرة: يحتاج الفريق إلى تسميات موثوقة لمدى الصلة أو طريقة تقييم أخرى يمكن الدفاع عنها، وعليه التحقق من أن المكافأة لا تفضّل تحسينات سطحية في الترتيب على حساب جودة الإجابة أو زمن الاستجابة أو تكلفة استخدام الأدوات.
تقول التدوينة إن مزيج التدريب شمل FRAMES وBRIGHT وEnterprise RAG وESCI وMusique وMLQA، مع حجز خمسة بالمئة من أمثلة التدريب في كل مجموعة بيانات للتحقق. وتألفت مجموعة الاختبار المحجوبة من FreshStack وWixQA وBrowseComp-Plus وWands. ولا تغني مجموعات البيانات العامة أو الاصطناعية هذه عن التقييم على مجموعة الوثائق الخاصة وتوزيع الاستعلامات اللذين ينوي الفريق خدمتهما.
أرسل مهمة صغيرة يسهل فحصها
تستخدم تدوينة AWS في 2 أكتوبر استيراد SDK وأسماء وسائط مختلفة في المقتطف البرمجي. أما مرجع مهمة التدريب في SageMaker الحالي فيعرض شكل واجهة API التالي لوقت تشغيل Bedrock AgentCore. يستخدم هذا المثال معرّف نموذج GPT-OSS-20B الحالي والموثق لدى AWS؛ اختر نموذجاً متاحاً في المنطقة المستهدفة وتحقق من جدول النماذج المدعومة الحالي قبل تكييف المثال. ويتطلب المثال الحالي أيضاً ARN لتطبيق MLflow وARN للدور وقبول اتفاقية ترخيص المستخدم النهائي (EULA).
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
هذا مثال من وثائق AWS الحالية، وليس أمراً برمجياً اختبرته BIG CHANGE. تعرض تدوينة AWS في 2 أكتوبر استيراداً مختلفاً لـ sagemaker.modules.train، ووسيط model_id، ووسيط agent_endpoint، ووسيط training_dataset_s3_uri، ووسيط output_s3_uri مختلفاً. وبما أن هذه التفاصيل تختلف عن دليل المهمة الحالي، فاتبع المرجع الحالي للتنفيذ الجديد وتحقق من إصدار SDK ومتطلبات النموذج في بيئتك؛ فلم نثبت ما إذا كان مثال التدوينة يعكس مراجعة أقدم من SDK أو تناقضاً في الوثائق. كما تمثل واجهة Studio مساراً آخر موثقاً لإرسال المهمة: اختر نموذج JumpStart مدعوماً، وحدد Multi-Turn Reinforcement Learning، واضبط وقت تشغيل AgentCore أو مُمرِّر Lambda، وقدّم بيانات التدريب ثم أرسل المهمة.
في التشغيل الأول، سجّل النموذج والمنطقة وإصدار مجموعة البيانات والمكافأة والحدود والمعلمات الفائقة ومسار المخرجات، حتى يمكن مقارنة تقييم لاحق بخط الأساس نفسه. وإذا استخدمت شبكة VPC يديرها العميل، فيحدد دليل VPC المنفصل لدى AWS شبكات فرعية خاصة في منطقتَي توافر، ونقاط نهاية VPC لـ S3 وCloudWatch Logs، إضافة إلى نقطة نهاية لـ AgentCore أو Lambda حسب الاقتضاء؛ كما يحتاج MLflow إلى نقطة نهاية عند استخدامه. ويحتاج دور التنفيذ إلى أذونات إدارة ENI. ويتطلب مسار KMS الاختياري الذي يديره العميل أذونات إضافية وإعداد سياسة المفتاح للمستدعي ودور التنفيذ ووقت التشغيل؛ أما التشفير أثناء التخزين باستخدام KMS المملوك لـ AWS فهو الإعداد الافتراضي. راجع دليلي VPC والتشفير قبل استخدام أي من الإعدادين. وقبل الإرسال، راجع حصص الحساب: تدرج AWS افتراضياً مهمة واحدة متزامنة للضبط الدقيق باستخدام MTRL ومهمة تقييم متزامنة واحدة، ويمكن تعديل كلتيهما عبر Service Quotas. أما حدود تقييد واجهات إدارة المهام فلا يمكن تعديلها.
قيّم المطالبات المحجوبة قبل النشر
تنص وثائق التقييم لدى AWS على إبقاء مطالبات التقييم خارج بيانات التدريب، واستخدام تنسيق المطالبات نفسه، وتغطية الأدوات المهمة ومجموعات الأدوات، وإدراج حالات فشل سابقة، وحماية المحتوى الحساس. ويمكن لمقيّم SageMaker تشغيل نموذج مرشح على مجموعة مطالبات والإبلاغ عن المكافأة ومقياس pass@k ومقاييس المسارات. وتعرض الوثائق تقييم نموذج مضبوط دقيقاً، مع خيار تقييم النموذج الأساسي في مسار المقارنة نفسه.
حدّد بروتوكول التقييم قبل التدريب. احتفظ بمجموعة ثابتة ومحجوبة تمثل الاستعلامات والأذونات والتغييرات في الوثائق التي سيواجهها الوكيل الفعلي. قارن النموذج الأساسي والمضبوط باستخدام الأدوات والحدود وشيفرة التقييم نفسها. ولا تكتفِ بفحص متوسط درجة الاسترجاع؛ بل راجع إخفاقات المهام وعدد الأدوار وزمن الاستجابة واستخدام الرموز والحالات التي تختفي فيها الوثائق ذات الصلة من المراتب الأولى. وتوضح الوثائق كيفية إرسال مهمة تقييم AWS، لكنها لا تثبت أن مقياساً واحداً يعبّر وحده عن جودة البحث في الإنتاج.
تورد تدوينة AWS النتائج المحجوبة التالية:
مجموعة البيانات (الأسئلة) | nDCG@10 الأساسي | nDCG@10 بعد الضبط الدقيق | معدل الإخفاق الأساسي | معدل الإخفاق بعد الضبط الدقيق |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
يُظهر الجدول ارتفاع nDCG@10 في ثلاث مجموعات وانخفاضاً طفيفاً في FreshStack. وتعزو AWS انخفاض معدل الإخفاق في BrowseComp-Plus إلى العقوبة المفروضة عند بلوغ حدود الأدوار أو الرموز. ولا تقدم التدوينة فواصل ثقة أو تحليلاً للدلالة الإحصائية إلى جانب هذه الأرقام. كما تفيد بأن النموذج المضبوط استخدم في المتوسط 4.5 أدوار مقابل 4.3 في WixQA، و2.9 مقابل 2.2 في Wands؛ لذا لم يكن عدد الأدوار أقل في جميع الحالات. تعامل مع هذا بوصفه تجربة أبلغت عنها الجهة المورّدة، لا تحققاً مستقلاً أو دليلاً على تحسن مجموعة بيانات أخرى.
ضع ميزانية للتجربة كاملة
تصف وثائق MTRL لدى AWS ثلاثة أبعاد لرسوم التدريب: رموز التهيئة المسبقة التي تُعالَج كمدخلات، والرموز المأخوذة بالاستدلال التي تُولَّد أثناء عمليات التنفيذ المرحلي، وتحديثات التدريب. وتعرض صفحة الأسعار معدلات خاصة بكل نموذج؛ وتتحدد التقديرات بتلك المعدلات وحجم عمليات التنفيذ المرحلي لدى الفريق وأطوال التسلسلات وعدد الدورات ومدة التشغيل. ولا تنشر المقالة المثال إجمالي فاتورته، كما لا تحدد الوثائق سعراً موحداً لأي تجربة. تحقّق من السعر الحالي للنموذج والمنطقة المختارين، ثم قدّر التكلفة من الاستخدام المتوقع للمهمة بدلاً من افتراض تكلفة ثابتة.
أدرج التكاليف المجاورة في التقدير: تخزين S3 وطلباته لبيانات التدريب والتحقق ونقاط الحفظ ومخرجات المهمة؛ ووقت تشغيل AgentCore أو Lambda وأي بنية بحث داعمة أثناء التنفيذ المرحلي؛ والتسجيل وMLflow؛ والتقييم المحجوب؛ وأي نقطة نهاية أو نشر عبر Bedrock بعد التدريب. وتنصح تدوينة AWS تحديداً بإيقاف مهمة MTRL قيد التشغيل أو حذفها، وحذف عناصر نماذج S3 غير اللازمة، وإزالة نقاط نهاية التقييم لتجنب استمرار الرسوم. فنشر نقطة نهاية قرار وفئة تكلفة منفصلان عن التدريب.
قرّر ما إذا كنت ستمضي قدماً
يكون هذا المسار أنسب عندما تتطلب مهمة البحث استدعاءات متعددة ومترابطة للأدوات ويستطيع الفريق تقييم النتيجة النهائية. ولا تكون التجربة مفيدة لاتخاذ القرار إلا إذا توفر زوج مدعوم من النموذج والمنطقة، وربط عامل للوكيل، وبيانات مطالبات ممثلة، ومكافأة تعكس المهمة، ومقارنة محجوبة، وتقدير للتكلفة يشمل الخدمات المحيطة. والنتيجة القوية على اختبارات AWS الأربعة سبب لفحص المنهج، لا لافتراض الأثر نفسه على فهرس أو مزيج استعلامات أو حدود أذونات مختلفة.
المصادر ومواد للقراءة الإضافية
- مدونة AWS للتعلّم الآلي: «ضبط وكيل بحث باستخدام التعلّم المعزّز متعدد الأدوار على Amazon SageMaker AI» (2 أكتوبر 2026) — دليل المورّد العملي والإعداد واختيارات مجموعات البيانات ونتائج التقييم المعلنة.
- Amazon SageMaker AI: التعلّم المعزّز متعدد الأدوار — النماذج والمناطق المدعومة حالياً وأبعاد الفوترة.
- المتطلبات المسبقة، إعداد وكيلك، إعداد VPC والتشفير أثناء التخزين — الأذونات وخيارات وقت التشغيل والربط وإعدادات الشبكة والتشفير الاختيارية.
- إنشاء الأصول، إرسال مهمة التدريب، التقييم، المعلمات الفائقة والحصص — مراجع التنفيذ الحالية.
- أسعار SageMaker AI — تفاصيل الأسعار الحالية لتخصيص النماذج؛ وقد تتغير الأسعار وتختلف حسب النموذج والمنطقة.
ملاحظة حول التغطية: مراجعة للوثائق فقط. لم تدخل BIG CHANGE إلى حساب AWS، أو ترسل مهمة SageMaker أو تفحصها، أو تستدع واجهات AWS البرمجية، أو تكرر المقاييس المعلنة بصورة مستقلة. ألّفت AWS دليل التنفيذ وأبلغت عن تجربتها الخاصة.