बड़ा बदलाव
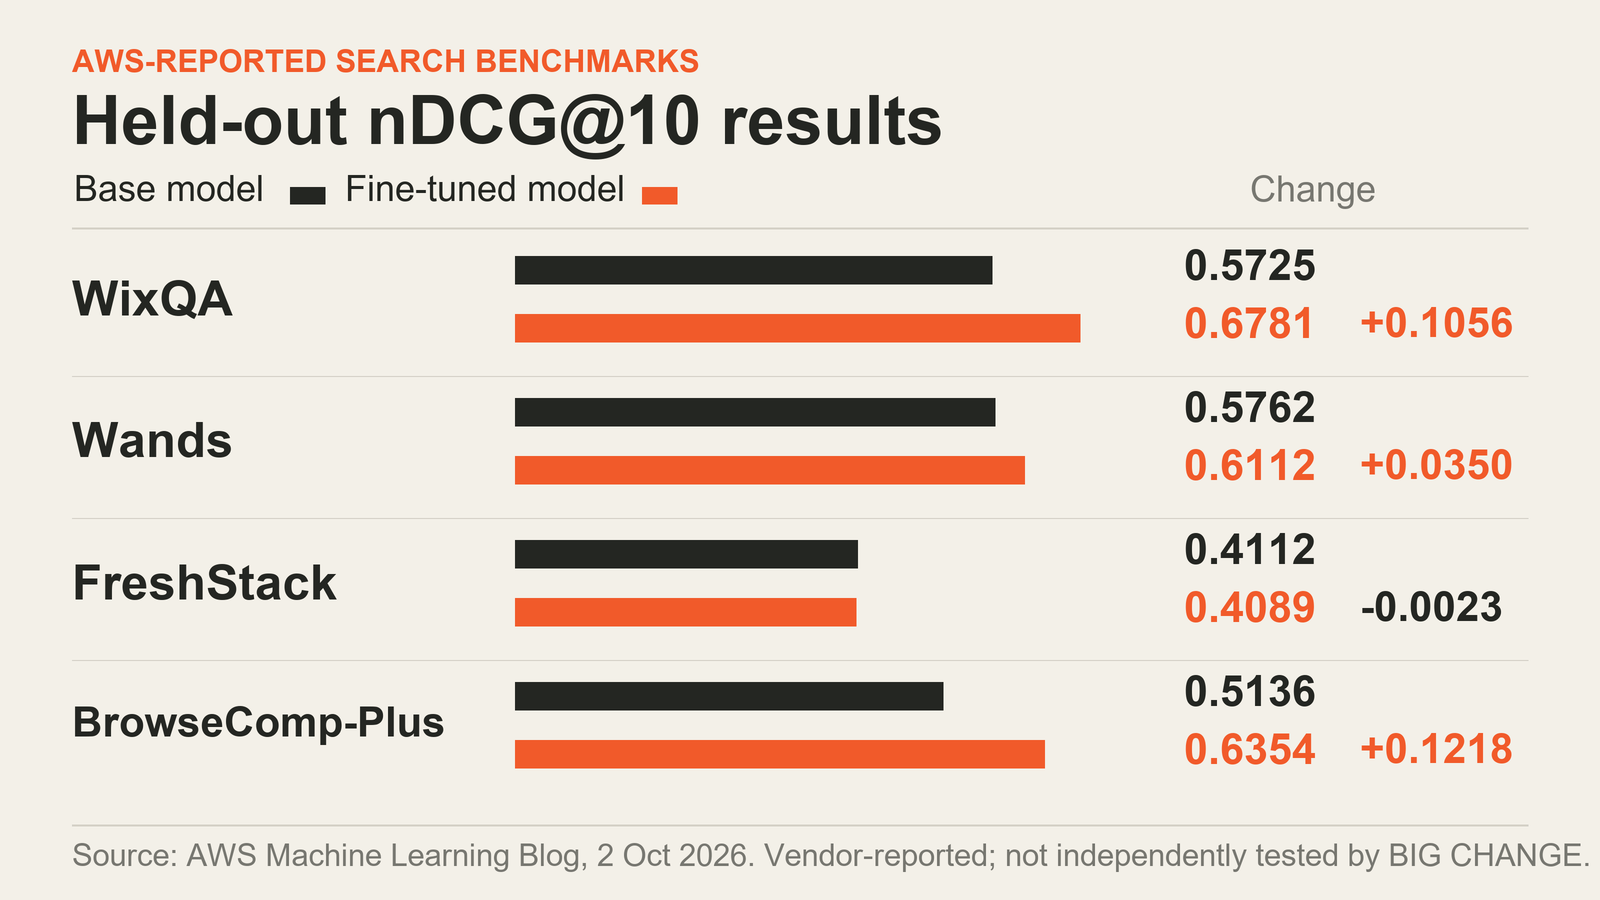
अपने 2 अक्टूबर के विवरण, AWS ने SageMaker AI में मल्टी-टर्न रीइन्फोर्समेंट लर्निंग (MTRL) के साथ Qwen3.6-27B खोज एजेंट को फाइन-ट्यून करने का तरीका बताया है। ऊपर का चार्ट AWS के बताए होल्डआउट nDCG@10 स्कोर दिखाता है: WixQA, Wands और BrowseComp-Plus पर स्कोर बढ़े, जबकि FreshStack पर थोड़ा घटे। BIG CHANGE ने AWS के आँकड़ों से चार्ट बनाया; हमने एजेंट का स्वतंत्र परीक्षण नहीं किया और न ही नतीजों को दोहराया। यह तकनीक टूल का उपयोग करने वाले निर्णयों की पूरी शृंखला के परिणाम के आधार पर मॉडल को प्रशिक्षित करती है।
जॉब सबमिट करने से पहले, मशीन लर्निंग इंजीनियर को पुष्टि करनी चाहिए कि मॉडल और क्षेत्र समर्थित हैं, एजेंट SageMaker के rollout loop में काम कर सकता है, prompts और rewards इच्छित खोज कार्य को दर्शाते हैं, और अलग मूल्यांकन सेट से प्रदर्शन में गिरावट पकड़ी जा सकती है। यह मार्गदर्शिका AWS दस्तावेज़ों पर आधारित है; BIG CHANGE ने AWS जॉब नहीं चलाया और न ही उसके API कॉल किए।
MTRL प्रशिक्षण लूप में क्या बदलता है
सुपरवाइज़्ड फाइन-ट्यूनिंग में टीम को वांछित व्यवहार दिखाने वाले उदाहरण trajectories चाहिए। AWS के MTRL विवरण में, SageMaker इसके बजाय एजेंट को prompts भेजता है; एजेंट कई चरणों में policy model और उसके टूल कॉल करता है, फिर पूरा rollout होने पर reward लौटाता है। उसी feedback से मॉडल अपडेट होता है। खोज में reward अंतिम ranking को स्कोर कर सकता है, जिससे शुरुआती query विकल्प पूरी खोज प्रक्रिया के संदर्भ में अनुकूलित होते हैं।
यह अंतर तब मायने रखता है जब टूल कॉल पहले के नतीजों पर निर्भर हों। यदि मॉडल पहली query खराब बनाता है, कमजोर नतीजे देखता है और उसे query दोबारा बनानी चाहिए, तो काम के अंत में दिया गया reward बता सकता है कि क्रम ने आखिरकार प्रासंगिक दस्तावेज़ ढूँढ़े या नहीं। फिर भी ‘प्रासंगिक’ का अर्थ तय करना और ऐसा एजेंट बनाना ज़रूरी है जो टीम के खोज टूल इस्तेमाल कर सके।
पहले पहुँच, मॉडल और क्षेत्र जाँचें
2 अक्टूबर का उदाहरण US West (Oregon) क्षेत्र में चलाया गया था, us-west-2, और इसमें Qwen3.6-27B को फाइन-ट्यून किया गया। SageMaker MTRL की समर्थित-मॉडल तालिका, जिसे 4 अक्टूबर 2026 को जाँचा गया, चार मॉडलों के छह मॉडल-क्षेत्र संयोजन दिखाती है: Nova Lite 2.0 और GPT-OSS-20B US East (N. Virginia) में, us-east-1, और US West (Oregon) में, us-west-2; Gemma-4-31B-it और Qwen 3.6 27B केवल Oregon में समर्थित हैं। जिस क्षेत्र में जॉब बनाना है, वहाँ की ताज़ा तालिका जाँचें; सूची में मॉडल होना दूसरे क्षेत्र में उपलब्धता का प्रमाण नहीं है।
टीम को AWS खाता और, यदि Studio इंटरफ़ेस इस्तेमाल कर रही हो, SageMaker Studio डोमेन भी चाहिए। डेटासेट और आउटपुट के लिए S3 पहुँच तथा नए MTRL जॉब और runtime कॉल के लिए IAM भूमिकाएँ कॉन्फ़िगर होनी चाहिए। AWS के prerequisites दस्तावेज़ के मुताबिक़, कॉल करने वाले को CreateJob और संबंधित जॉब कार्रवाइयों की अनुमति, साथ ही execution role को job.sagemaker.amazonaws.com को सौंपने की अनुमति चाहिए। Execution role को AmazonSageMakerJobFullAccess policy और अपनी trust policy में उस service principal की ज़रूरत है। Agent runtime role को AmazonSageMakerJobRuntimeAccess चाहिए; AgentCore runtime को अपना trust relationship भी चाहिए। Studio में runtime चुनने के लिए AgentCore सूचीबद्ध करने की अनुमति आवश्यक है। AWS के अनुसार, पहले से मिली व्यापक SageMaker पहुँच में ये सभी नई job कार्रवाइयाँ अपने-आप शामिल नहीं होतीं।
दस्तावेज़ों में एजेंट चलाने के दो तरीके हैं। Managed hosting के लिए Bedrock AgentCore पर deploy करें; AWS कहता है कि Strands से बने एजेंटों के साथ यह तरीका सबसे अच्छा काम करता है। या अपना एजेंट host करके Lambda forwarder के ज़रिए जोड़ें। एजेंट rollout prompts प्राप्त करता है, SageMaker job runtime से policy model को कॉल करता है, अपने खोज टूल चलाता है, हर rollout पूरा करता है और reward लौटाता है। AWS का SDK decorator इस एकीकरण का अधिकांश काम संभालता है; custom framework सीधे runtime APIs कॉल कर सकते हैं। यदि Lambda function का नाम सामान्य नाम से अलग है, तो AWS के मुताबिक़ उसका ARN permission policy में स्पष्ट रूप से जोड़ना पड़ सकता है। ग्राहक-प्रबंधित VPC या KMS key इस्तेमाल करने पर अतिरिक्त सेटअप चाहिए।
वास्तविक खोज कार्य के लिए prompts और reward तैयार करें
SageMaker की asset मार्गदर्शिका Parquet, JSON Lines, JSON या CSV स्वीकार करती है। यह नाम वाला column खोजती है prompt, और ऐसा column न मिले तो पहले column का उपयोग करके उसकी वैल्यू ज्यों की त्यों एजेंट को देती है। सेवा prompt content को parse, validate या transform नहीं करती। टूल-आधारित खोज में prompt में बातचीत के संदेश, task metadata, reward specification और टूल configuration हो सकते हैं—उस format में जिसे एजेंट समझता हो। AWS चेतावनी देता है कि prompts बिना जाँच के आगे भेजे जाते हैं, इसलिए संवेदनशील डेटा की सुरक्षा टीम की ज़िम्मेदारी है; storage और एजेंट तक जाने वाले रास्ते में encryption या कोई अन्य उपयुक्त सुरक्षा शामिल करें।
Reward वह लक्ष्य है जिसे मॉडल अनुकूलित करेगा। AWS का उदाहरण अंतिम खोजे गए दस्तावेज़ों पर nDCG@10 इस्तेमाल करता है और एजेंट के turn या sampling-token की सीमा तक पहुँचने पर -1 reward देता है। Ranked retrieval कार्य के लिए यह एक ठोस शुरुआती तरीका है, लेकिन इससे मूल्यांकन के फैसले अहम हो जाते हैं: टीम को विश्वसनीय relevance labels या स्कोर करने का कोई और बचाव-योग्य तरीका चाहिए। यह भी जाँचें कि reward सतही ranking सुधार को बढ़ावा देकर जवाब की गुणवत्ता, latency या टूल लागत को नुकसान न पहुँचाए।
ब्लॉग पोस्ट के मुताबिक़, प्रशिक्षण मिश्रण में FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique और MLQA थे; हर dataset के पाँच प्रतिशत training उदाहरण validation के लिए रखे गए। होल्डआउट test set में FreshStack, WixQA, BrowseComp-Plus और Wands थे। ये सार्वजनिक या synthetic datasets उस निजी corpus और query वितरण पर मूल्यांकन की जगह नहीं ले सकते जिसे टीम सेवा में चलाना चाहती है।
छोटी और जाँचने योग्य जॉब सबमिट करें
इस 2 अक्टूबर के AWS ब्लॉग में code snippet के लिए अलग SDK import और argument नाम इस्तेमाल हुए हैं। मौजूदा SageMaker training-job reference Bedrock AgentCore runtime के लिए API का यह रूप दिखाता है। उदाहरण AWS दस्तावेज़ों में दिया गया मौजूदा GPT-OSS-20B model identifier इस्तेमाल करता है। अपने लक्ष्य क्षेत्र में उपलब्ध मॉडल चुनें और उदाहरण बदलने से पहले समर्थित मॉडलों की ताज़ा तालिका जाँचें। मौजूदा उदाहरण में MLflow app ARN, role ARN और EULA स्वीकार करना भी ज़रूरी है।
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
यह AWS के मौजूदा दस्तावेज़ का उदाहरण है; BIG CHANGE ने इसे command के रूप में नहीं जाँचा। 2 अक्टूबर का AWS ब्लॉग अलग sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri और output_s3_uri arguments दिखाता है। ये मौजूदा job guide से अलग हैं, इसलिए नए implementation के लिए मौजूदा reference अपनाएँ और अपने वातावरण में SDK version तथा model की ज़रूरतें जाँचें। हमने यह तय नहीं किया है कि ब्लॉग का उदाहरण SDK के पुराने संस्करण पर आधारित है या दस्तावेज़ों में असंगति है। Studio UI भी दस्तावेज़ों में दिया गया submission तरीका है: समर्थित JumpStart model चुनें, Multi-Turn Reinforcement Learning चुनें, AgentCore runtime या Lambda forwarder सेट करें, training data दें और submit करें।
पहली बार चलाते समय मॉडल, क्षेत्र, dataset version, reward, सीमाएँ, hyperparameters और output path दर्ज करें, ताकि बाद के मूल्यांकन की तुलना उसी baseline से हो सके। Customer-managed VPC इस्तेमाल करने पर AWS की अलग VPC guide के मुताबिक़ दो Availability Zones में private subnets और S3 तथा CloudWatch Logs के VPC endpoints चाहिए; ज़रूरत पड़ने पर AgentCore या Lambda endpoint भी चाहिए। MLflow इस्तेमाल हो तो उसके लिए भी endpoint चाहिए। Execution role को ENI प्रबंधन की अनुमति चाहिए। वैकल्पिक customer-managed KMS व्यवस्था में caller, execution role और runtime के लिए अतिरिक्त permissions तथा key-policy सेटअप चाहिए; डिफ़ॉल्ट रूप से डेटा rest में AWS-owned KMS key से encrypt होता है। इनमें से कोई व्यवस्था इस्तेमाल करने से पहले VPC और encryption guides पढ़ें। Submit करने से पहले account quotas जाँचें: AWS डिफ़ॉल्ट रूप से एक साथ एक MTRL fine-tuning job और एक evaluation job की अनुमति देता है; दोनों Service Quotas से बदले जा सकते हैं। Job-management API की throttling सीमाएँ नहीं बदली जा सकतीं।
Deploy करने से पहले holdout prompts पर मूल्यांकन करें
AWS के evaluation दस्तावेज़ कहते हैं कि evaluation prompts को training से बाहर रखें, वही prompt format इस्तेमाल करें, अहम tools और उनके संयोजनों को शामिल करें, पहले विफल हुए मामलों को भी रखें और संवेदनशील content सुरक्षित रखें। SageMaker का evaluator किसी prompt set पर candidate चला सकता है और reward, pass@k तथा trajectory metrics दे सकता है। दस्तावेज़ fine-tuned model का मूल्यांकन और उसी comparison pipeline में base model का वैकल्पिक मूल्यांकन दिखाते हैं।
प्रशिक्षण से पहले evaluation protocol तय करें। ऐसा स्थिर holdout set रखें जो live agent को मिलने वाली queries, permissions और document changes को दर्शाता हो। Base और tuned models की तुलना एक जैसे tools, limits और scoring code पर करें। सिर्फ़ औसत retrieval score नहीं, बल्कि task failures, turns की संख्या, latency, token उपयोग और वे मामले भी देखें जहाँ प्रासंगिक दस्तावेज़ शीर्ष रैंक से गायब हो जाते हैं। दस्तावेज़ बताते हैं कि AWS का evaluation job कैसे submit किया जाए; वे यह साबित नहीं करते कि कोई एक metric production search quality को पूरी तरह मापता है।
AWS की पोस्ट में ये होल्डआउट नतीजे दिए गए हैं:
Dataset (प्रश्न) | Base nDCG@10 | Fine-tuned nDCG@10 | Base विफलता दर | Fine-tuned विफलता दर |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
तालिका में nDCG@10 के तीन सुधार और FreshStack पर एक छोटी गिरावट दिखती है। AWS BrowseComp-Plus की कम विफलता दर का कारण turn या token सीमा तक पहुँचने पर दिए गए penalty को बताता है। ब्लॉग इन आँकड़ों के साथ confidence intervals या statistical significance analysis नहीं देता। यह भी बताता है कि fine-tuned model ने WixQA पर औसतन 4.5 बनाम 4.3 turns और Wands पर 2.9 बनाम 2.2 turns लिए; इसलिए कम turns हर जगह नहीं दिखे। इसे vendor द्वारा रिपोर्ट किया गया प्रयोग मानें—स्वतंत्र सत्यापन या इस बात का प्रमाण नहीं कि दूसरे corpus में भी सुधार होगा।
पूरे परीक्षण का बजट बनाएँ
AWS का MTRL दस्तावेज़ प्रशिक्षण के तीन charge dimensions बताता है: input के रूप में process किए गए prefill tokens, rollouts के दौरान बने sampled tokens और training updates। Pricing page पर model-specific rates दिए गए हैं; उन दरों के साथ rollout की संख्या, sequence lengths, epochs और runtime मिलकर अनुमानित लागत तय करते हैं। उदाहरण लेख कुल बिल नहीं बताता और दस्तावेज़ कोई एक सार्वभौमिक trial price नहीं देते। चुने हुए model और क्षेत्र की मौजूदा दर जाँचें और तय लागत मानने के बजाय अपेक्षित job उपयोग से अनुमान लगाएँ।
अनुमान में आसपास की लागतें भी जोड़ें: training, validation, checkpoints और output artifacts के लिए S3 storage तथा requests; rollouts के दौरान AgentCore runtime या Lambda और सहायक search infrastructure; logging और MLflow; holdout evaluation; तथा training के बाद इस्तेमाल किया जाने वाला कोई endpoint या Bedrock deployment। AWS की पोस्ट खास तौर पर चल रही MTRL job रोकने या मिटाने, गैर-ज़रूरी S3 model artifacts हटाने और evaluation endpoints हटाने की सलाह देती है, ताकि शुल्क जारी न रहें। Endpoint deployment, training से अलग फैसला और लागत श्रेणी है।
आगे बढ़ने का फैसला करें
यह workflow उन खोज कार्यों के लिए सबसे उपयोगी है जिनमें कई परस्पर निर्भर tool calls हों और टीम अंतिम नतीजे को स्कोर कर सके। परीक्षण तभी निर्णय लेने में काम आएगा जब model-region संयोजन समर्थित हो, agent integration काम करे, prompt data प्रतिनिधि हो, reward task को दर्शाए, holdout तुलना हो और अनुमान में सहायक सेवाओं की लागत भी शामिल हो। AWS के चार benchmarks पर मज़बूत नतीजा इस तरीके को जाँचने का कारण है, किसी दूसरे index, query mix या permission सीमा पर वही प्रभाव मान लेने का आधार नहीं।
स्रोत और आगे पढ़ें
- AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (2 अक्टूबर 2026) — vendor की मार्गदर्शिका, सेटअप, dataset विकल्प और रिपोर्ट किए गए मूल्यांकन नतीजे।
- Amazon SageMaker AI: Multi-turn reinforcement learning — समर्थित मौजूदा मॉडल, क्षेत्र और billing के आयाम।
- पूर्वापेक्षाएँ, एजेंट तैयार करना, VPC configuration और rest में encryption — permissions, runtime के विकल्प, एकीकरण और वैकल्पिक network/encryption सेटअप।
- Assets बनाना, training job सबमिट करना, मूल्यांकन, hyperparameters और quotas — implementation के मौजूदा संदर्भ।
- SageMaker AI की कीमतें — model customization की मौजूदा कीमतें; दरें model और क्षेत्र के अनुसार बदलती हैं।
रिपोर्टिंग नोट: यह केवल दस्तावेज़ों की समीक्षा है। BIG CHANGE ने AWS खाते में प्रवेश नहीं किया, SageMaker job submit या inspect नहीं की, AWS APIs कॉल नहीं किए और रिपोर्ट किए गए metrics को स्वतंत्र रूप से दोहराया नहीं। Implementation guide AWS ने लिखी है और प्रयोग के नतीजे भी उसी ने रिपोर्ट किए हैं।